 陆吾
AI 数据中心的带宽:GPU 算得快,数据跟得上吗?
一座 AI 数据中心装了上万张 GPU,算力很大,但一个训练任务能用上多少,要看这些 GPU 怎样协作。某张卡算完了自己的部分,下一步需要另一张卡的结果;如果结果还在路上,它就得等。
推理也有类似的等待。用户看到模型逐字输出,GPU 背后却在读取权重、访问上下文缓存,有时还要把中间结果交给别的 GPU。输出的文字很少,内部搬运的数据可以很多。
理解带宽,可以从一次计算需要的数据出发:字节在哪里,经过哪些连接,必须什么时候到达。扩容时,这几个问题能帮助我们找到该升级的路径。
先画出数据走的路
HBM 是封装在 GPU 附近的高带宽内存。权重、激活和 KV cache 等数据可以放在这里,计算单元需要不断读写它们。芯片内部还有寄存器和缓存,所以一次运算实际访问 HBM 的次数,也受数据复用方式影响。
模型拆到多张 GPU 上以后,出现第二种搬运:GPU 之间交换数据。NVLink 和相应的交换系统,可以为一个紧密协作的 GPU 域提供连接。这类扩展通常称为 scale-up。域的边界由具体架构决定,既可能在服务器内,也可能跨多个计算托盘。
再扩大到多个节点或机柜,通信通常需要网卡和交换网络,可以采用 InfiniBand,也可以采用面向 AI 配置的以太网。这通常称为 scale-out。计算通信、存储访问和管理流量,还可能使用不同的网络。NVIDIA:机柜系统的网络分工
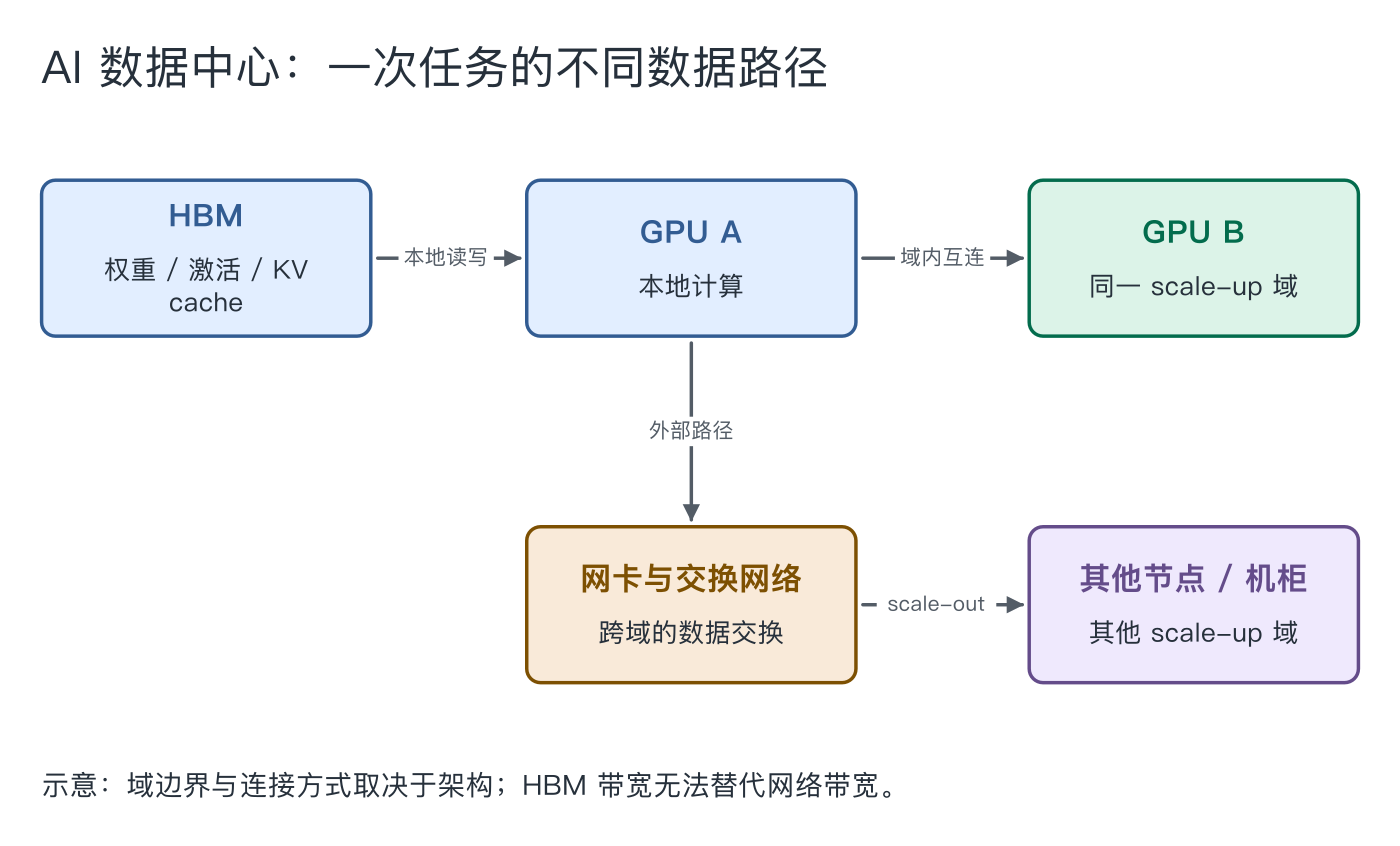
图 1:这是数据路径的示意,具体产品的连接与域边界会不同。一次任务可以同时使用多条路径。
Google 的 TPU v5p 规格也把这些能力分开列出:每芯片 HBM 带宽为 2765 GB/s,芯片间 ICI 互连为 1200 GB/s 双向合计,数据中心网络 DCN 为 50 Gb/s。它们服务于不同的数据路径,无法互相替代。Google Cloud:TPU v5p
升级本地内存,能改善 GPU 取数;升级域内互连,能改善多卡协作;升级外部网络,则可能改善跨域交换。收益取决于当前任务正在等待哪一项。
推理的第一处压力:从内存里反复取数
大模型生成一个 token,需要完成一轮前向计算。对密集模型,低批量解码时权重的复用机会有限,读取权重的成本可能很显眼。
举一个只用于估算的例子:假设一个 700 亿参数的密集模型,每个参数占 2 字节,权重约为 140 GB;这组权重已装入足够容量的 GPU 内存。本次单请求解码需要从 HBM 读取全部权重一次,相关设备合计能提供 4 TB/s 的有效读取吞吐,而且分片工作均衡。
仅搬运权重,就需要:
140 GB ÷ 4000 GB/s = 35 ms
按这个简化模型,权重读取给出的速率上限约为每秒 28.6 个 token。这里还没计入 KV cache、计算、中间结果读写和多卡通信,不能把这个数当作某款硬件的实测性能。
140 GB 的权重即使装得下,读取也要花时间。容量回答“能放多少”,带宽回答“每秒能搬多少”。
批处理会改变这笔账。同一轮处理多个请求时,矩阵运算可以让一份权重服务更多 token,提高数据复用和计算量与搬运量之比。不过,总吞吐提升也要和排队时间、单请求延迟一起看。批量增大、上下文变长或模型结构变化后,瓶颈可能转向计算、缓存访问或通信。NVIDIA:推理阶段与资源特征
软件也能减少搬运。FlashAttention 使用分块计算,把更多工作留在片上存储中,减少 HBM 与 SRAM 之间的读写;它的收益来自算法对内存层次的利用。FlashAttention 原论文
减少读写次数后,同样的内存带宽可以完成更多工作。分析 HBM 时,需要同时测量有效读取吞吐与实际访问量。
训练为什么需要 GPU 之间交换结果
多卡训练的通信,随模型分工方式变化。
数据并行让不同 GPU 处理不同样本,再同步梯度或相关分片。张量并行把某些层的运算拆开,各卡要交换部分结果;流水线并行把不同层放到不同阶段,阶段之间传递激活和反向梯度。这些分工可以组合使用,通信的频率和消息大小也会随实现变化。Megatron Core:并行策略
以 AllReduce 为例,它把参与者的数据逐元素归约,并让每个参与者得到结果。对理想的 ring AllReduce,若有 n 个参与者,每个参与者的输入大小为 S,每个参与者发送的总数据量约为:
2 × (n−1) / n × S
8 个参与者、每个输入 1 GB,则每个参与者约发送 1.75 GB,并接收相应数据。若每个参与者的有效单向吞吐是 50 GB/s,大消息的搬运部分约需 35 ms。这忽略了启动、分轮依赖与拥塞,也没有计入计算重叠。nccl-tests:AllReduce 的带宽模型
实际系统可以选择树形算法、分层归约或网络内计算,不能把 ring 模型套到所有配置。但它说明了为什么“同步一个 1 GB 张量”不能简单理解成每张卡只发送 1 GB。
更快的互连能缩短这类交换。如果一次迭代原本用 80 ms 计算、20 ms 通信,两者完全不重叠,把通信时间减半,总时间从 100 ms 变成 90 ms,速度提高约 11.1%。若部分通信本来就被计算隐藏,收益还要看剩下多少等待落在关键路径上。CUDA:性能扩展与 Amdahl 法则
评估训练网络时,需要在任务时间线上找到这些未被计算隐藏的通信。
MoE 把通信变成了频繁的定向交换
混合专家模型(MoE)会为 token 选择部分专家。专家分散在不同 GPU 上时,系统需要把对应的激活送过去,再把结果合回来;这里搬运的是 token 的向量表示,数据量远大于 token 编号本身。
这类专家并行常使用 All-to-All:不同参与者向不同目标发送不同数据。它与所有人求同一个和的 AllReduce,流量分布不同。NCCL:集合操作 Megatron Core:MoE 的 token dispatcher
如果路由把大量 token 送给同一批专家,那些 GPU 会承担更多接收和计算工作。即使其他路径还有空闲,热门专家仍可能排队。这时同时存在连接容量和负载分配问题。低批量解码还可能产生许多较小的交换,每次启动与完成同步的开销也会变得明显。NVIDIA:MoE 的通信与负载挑战
NVIDIA 为 GB200 NVL72 列出 72 个 GPU 的 NVLink 域,以及约 130 TB/s 的域级带宽;另一份网络文档给出的每 GPU NVLink 5.0 带宽为 1.8 TB/s 双向合计。这描述了机柜内紧密协作的能力,但域级数字不能当作某张 GPU 向某个目标的单向吞吐。GB200 NVL72 规格 NVLink 网络说明
要判断一个 MoE 部署能否受益,还得看专家放置、热点、批量,以及交换能否与计算重叠。把经常互相交换数据的 GPU 放到快路径上,是部署时需要考虑的一件事。
长上下文增加的不只是内存占用
KV cache 保存先前 token 在注意力层产生的 key 和 value,避免生成后续 token 时重复计算它们。缓存会占用内存,解码时还需要访问相关缓存。对标准的全注意力层,上下文变长,缓存量也会增长;滑动窗口、压缩和其他注意力结构会改变增长方式。Hugging Face:缓存机制 缓存策略
如果把输入处理(prefill)和逐 token 生成(decode)分到不同 GPU 池,prefill 完成后,通常需要把 KV cache 交给 decode 池。这让两阶段能够分别配置资源,也增加了转移成本。NVIDIA Dynamo:分离式推理
可以估一下这笔成本。假设一个教学模型有 80 层,每层 8 个 KV 头,每头维度 128,缓存每元素占 2 字节。单条请求含 32,768 个 token,所有层均采用标准全注意力,未做压缩或前缀复用,则 K 和 V 合计为:
2 × 80 × 8 × 128 × 32768 × 2 B ≈ 10.74 GB
假设整个逻辑缓存必须穿过一条有效吞吐为 80 GB/s 的路径,仅数据搬运就约需 134 ms。若有多请求共享出口,还需要计入竞争。这是由缓存张量大小得到的估算;实际系统的分片、布局、复用与传输方式会改变每条路径上的负载。
分离式推理是否划算,要比较两阶段各自提效的收益与转移成本。对短输入、低并发,或缺少快速缓存传输网络的配置,把两阶段留在一起可能更合适。Dynamo 文档也明确指出,分离部署不会自动更快。
网卡很快,网络内部仍可能堵
一张 800 Gb/s 网卡,按单位换算对应 100 GB/s;应用可以获得的有效吞吐还会受到协议和系统开销影响。更容易漏掉的是,许多网卡后面可能共用同一个出口。
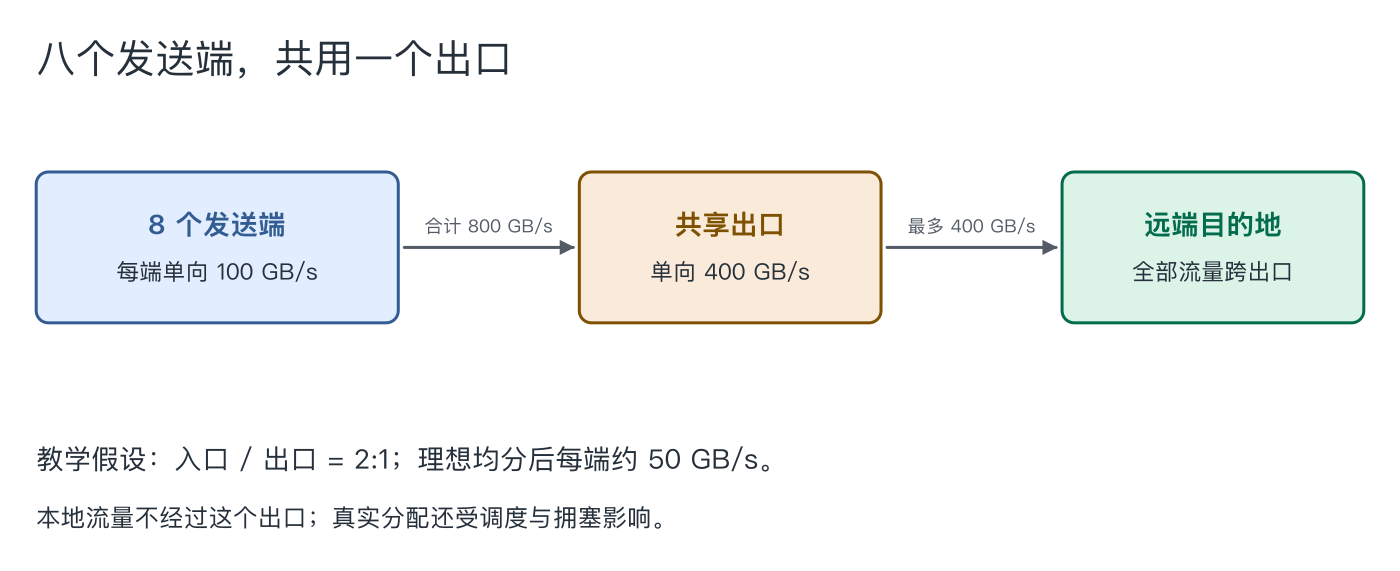
图 2:假设八个发送端各有 100 GB/s 单向容量,却共同使用 400 GB/s 出口,入口合计与出口的容量比为 2:1。
当这八个端点都向出口另一侧发送数据时,共享出口限制了总吞吐。理想均分下,每个发送端只有 50 GB/s。若目的地就在本地、流量不经过这个出口,则不受这处瓶颈限制。
这就是拓扑和流量位置的作用。超订阅比描述入口与共享出口的容量关系;二分带宽则关注把网络近似等分后,跨分界的连接能提供多少容量。端口速率相同,两张网络在跨区域交换时仍可能表现不同。NVIDIA 互连网络课程:拓扑与二分带宽
跨机柜网络还要管理拥塞和突发流量。RDMA 可以减少传统数据搬运路径中的软件和 CPU 参与,但链路容量与共享出口仍然存在。NVIDIA 的 AI 网络参考架构把拥塞控制、路由和遥测列为网卡与网络设计的一部分。NVIDIA:网络组件与拥塞控制
对同步任务,部分参与者晚完成可能拖住整个通信组。除了平均吞吐,还需要查看慢操作与尾部延迟。
铜线和光互连,解决哪一段搬运
规模扩大以后,连接需要同时满足距离、带宽密度、功耗和可维护性的要求。铜与光的选择取决于连接位置;不能仅凭“光更先进”决定方案。
Broadcom 在光互连产品资料中同时提供面向短距离的高速铜连接和光连接。CPO(共封装光学)则把光引擎与芯片放到同一个封装基板上,缩短高速电信号到光转换之间的路径,目标包括改善带宽密度和功耗。Broadcom:铜与光连接方案 CPO 技术说明
这些技术改善的是物理连接。热门专家上的负载、共享出口的容量,以及软件的通信安排,仍要由相应的系统设计解决。分析一项互连升级时,需要先标出它作用于哪一段路径,再观察任务的等待是否随之减少。
给带宽升级选一个能验收的目标
对一座具体的数据中心,我会先拿到一次任务的时间线,再决定测什么:
| 观察到的现象 | 需要检查的路径或环节 | 业务上验收什么 |
|---|---|---|
| 低批量解码慢 | 权重与 KV cache 的 HBM 访问、计算耗时 | 固定上下文下的单请求 token 延迟 |
| 多卡扩容后提升很小 | 集合操作、拓扑和未隐藏的通信 | 训练迭代耗时、扩容后的有效吞吐 |
| MoE 个别 GPU 长时间繁忙 | 专家路由、接收热点与计算不均衡 | 负载分布及尾部完成时间 |
| 长输入首 token 很慢 | prefill 计算、排队和缓存转移 | 首 token 时间及其分项 |
| 单机快、跨机柜慢 | 网卡路径、共享出口、拥塞和放置 | 真实流量下的操作耗时分布 |
这些现象只能给出排查方向,不能单凭它们断定原因。一次有用的测量需要固定模型、精度、批量、上下文长度、并行策略和设备位置,才能比较升级前后。
如果目标是降低训练成本,就看每次迭代少了多少等待;如果目标是让聊天响应更快,就同时看首 token 和后续 token 的延迟;如果目标是提高服务吞吐,就在既定延迟要求下比较能承载多少请求。带宽规格给出容量,任务时间线告诉我们这份容量有没有用上。
资料核实日期:2026-10-12。算例采用十进制 GB、TB,明确标为假设的算例用于解释数据量与时间的关系,均非硬件实测。